从行情到模拟成交:DolphinDB 如何打通交易执行链路

图:模拟仿真成交明细在量化交易系统中,从原始行情接入到成交输出,中间并不是简单地完成因子计算和模型推理就结束了。而是要经过分钟频聚合、多源因子合并、模型推理、信号生成、委托构建、订单撮合等一系列环节。
尤其是在高频场景下,一套交易系统每天要处理的数据量能达到亿级,任何一个环节稍有延迟或衔接不上,都可能让整条链路在实时压力下掉链子。因而,对于自建量化系统的团队来说,真正困难的往往不是实现某一个环节,而是如何让这些环节在实时场景下能够稳定衔接。
在真正接入实盘之前,团队往往会先自建一套回测系统来验证策略。而传统的回测方案中,流计算、模型服务、订单管理、模拟撮合往往分散在不同系统里,依靠人工编写胶水代码维持数据流转和状态同步。链路一长,就容易出现字段口径不一致、时间对齐困难、状态不同步、仿真和实盘逻辑脱节等问题。最后得到的仿真结果,可能并不能真实反映策略进入交易链路后的执行表现。
为了解决上述问题,DolphinDB 基于自身的实时计算、撮合、推理、订单管理等组件化能力进行封装,推出了 SnapTradeStream 模块。完整的模块和示例代码请点击http://dolphindb.com/downloads/tutorials/script/SnapTradeStream_tu.zip进行下载。
用统一流计算框架串联交易链路
SnapTradeStream 模块主要解决的问题是把从行情到成交的关键流程,组织成一条统一的流计算链路。它打通的不只是“行情到信号”,而是进一步延伸到了“信号到订单、订单到成交”的执行验证环节。
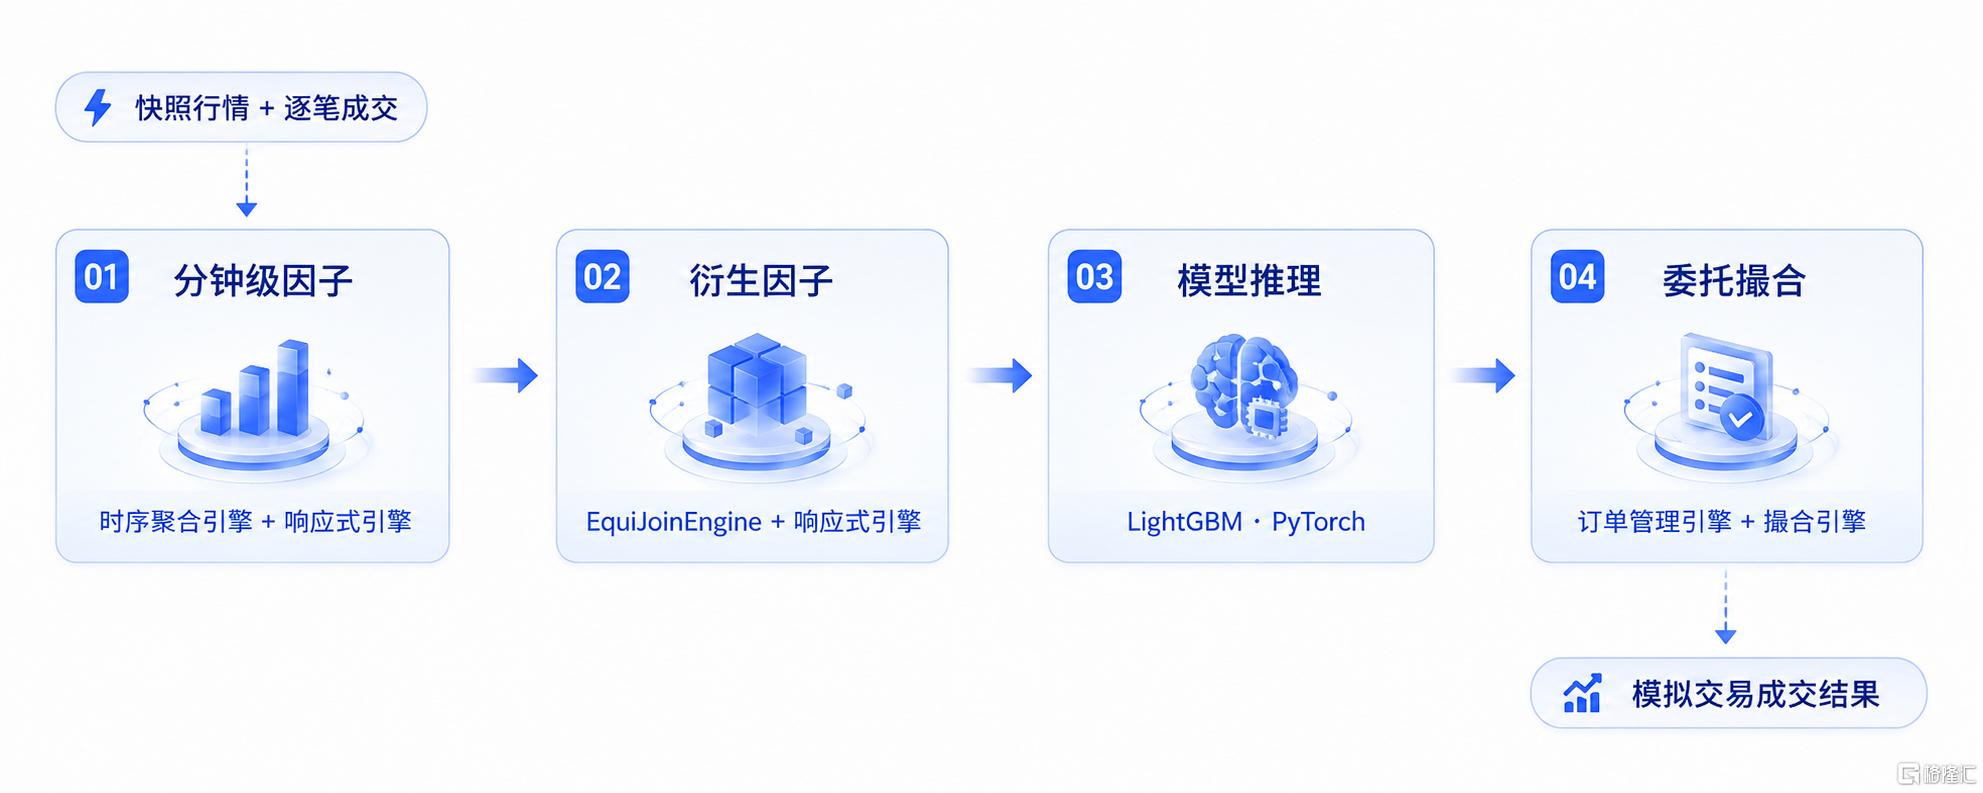
用户只需将快照行情和逐笔成交数据写入 DolphinDB 流表,系统就能自动跑完从行情处理、因子挖掘,到模型决策、模拟下单成交的完整链路。
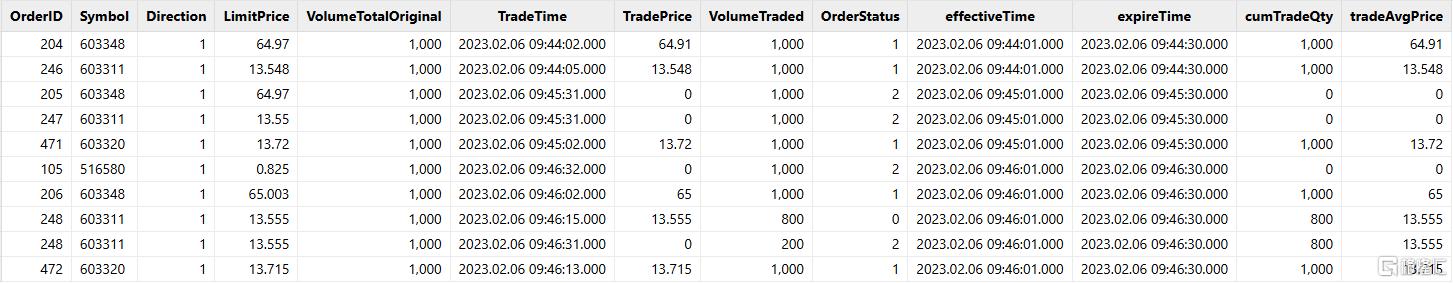 图:模拟仿真成交明细
注意:
SnapTradeStream模块依赖模拟撮合引擎(MatchingEngineSimulator)与订单管理引擎插件OrderManagementEngine插件,使用模块前需要在插件市场下载安装依赖插件,其中模拟撮合引擎为收费插件。
模块内部做了什么
SnapTradeStream 模块的核心并不是简单封装几个计算函数,而是把交易链路中的多个状态处理环节连接起来。从数据清洗、分钟因子合成,到模型推理、订单撮合,这些环节看起来是各自独立的处理步骤,但在模块内部的逻辑里,它们其实是一条首尾相连的流水线——上一步的输出,直接就是下一步的输入,中间不需要人工搬运数据,也不需要额外写胶水代码去对齐格式和时间戳。
为了帮助大家更好了解并使用模块,下面我们按顺序拆解这几个环节,看看每一步具体做了什么。
数据清洗与时间对齐
在分钟因子生成环节,模块会先对输入的快照行情和逐笔成交数据做时间维度的处理:过滤非交易时段的记录、将开盘前的早期报价归并到正式开盘时间,并对分钟边界上的数据做时间戳修正,确保交易时间在跨批次场景下保持有序,避免窗口计算错位。
分钟因子合成与衍生计算
处理后的快照行情会经过时间序列聚合,生成 OHLC、成交量、成交额、委托总量与加权均价等分钟级行情因子;逐笔成交数据则会被聚合为主动买卖金额、大单小单金额、成交偏离等分钟级成交因子。两类分钟因子生成后,会通过流连接引擎按照证券代码和交易时间进行对齐,再由响应式状态引擎计算衍生指标。
模块内置了一部分成交与盘口相关的因子,例如成交额与盘口委托的关系、大单成交占比、价格偏离、流动性消耗和市场压力等。如果用户需要接入其它因子,模块也提供了统一的因子注册机制:只需要定义因子计算逻辑、输出字段名和数据类型,底层的时间序列计算、状态计算和持久化订阅由框架统一创建。因此,新增或替换因子时,通常只需要修改因子函数,不需要改动底层流计算框架。
模型推理与信号生成
这些指标在生成的同时会落库保存,作为机器学习模型的输入,用于实时推理生成交易信号。
模块采用 LightGBM 与 PyTorch 双模型协同推理的设计,需要同时配置两类模型;衍生因子进入模型进行推理后,会输出买入、卖出或持平等分类结果,并据此生成最终策略信号。随后,系统进一步将策略信号转换为包含方向、价格、数量、生效时间和失效时间等信息的委托订单。
订单管理与模拟撮合
信号生成后不会停留在中间结果表中,而是会继续流入订单管理引擎。订单管理引擎负责维护订单生命周期,包括订单创建、状态更新、撤单、部分成交处理和拒单记录。每笔订单还可以设置生效和失效时间,一旦超过有效期仍未成交,系统会自动触发撤单,不会让委托单无限期挂在盘口上——这个细节让模拟环境更贴近真实交易里"订单都有时效"的约束,也让仿真结果更可信。
接下来,这些订单会进入模拟撮合环节:系统根据实时快照行情构造出撮合所需的报价数据,结合策略订单进入撮合引擎完成模拟撮合,输出成交价格、成交数量、订单状态、成交均价和拒单信息等完整成交明细。这些信息让策略评估能从"预测准不准"延伸到"进场后能否成交、成交价格是否合理"这类执行层面的问题——撮合引擎甚至会记录订单排队时前面压了多少未成交量、盘口有几档价格比你更优,让"这笔单子卡在哪儿、为什么没成交"这件事变得可追溯,而不是一个黑箱结果。
是否只能用于模拟
走完这四个环节,一笔完整的模拟成交才算真正跑通。这也带来一个自然的问题:这套流程是不是只能停留在"模拟"这一步?
从当前实现来看,SnapTradeStream 模块默认提供的是一套从行情到模拟成交的验证框架,内置的订单执行环节依赖模拟撮合引擎,并不是开箱即用的实盘交易系统。
不过,模块中的实时行情处理、因子计算和模型推理部分,也可以作为实盘系统中的信号生产层使用。若要接入真实交易,用户需要将订单输出对接到券商接口、OMS 或交易网关,并用真实执行模块替换最后的模拟撮合环节。
因此,SnapTradeStream 模块不仅适合用于策略上线前的历史回放、实时仿真、成交质量分析和影子交易,也可以作为实盘系统中的实时因子与信号生产层。
性能与开发效率
在实时性上,DolphinDB 从 3.00.4 版本开始支持低延时计算,为流计算引擎打开这一开关后,因子计算的响应速度有明显提升。实测数据显示,随着股票数量从百支扩大到千支,这种提升会更加明显——在千支股票规模下,衍生因子计算的耗时最多可以降至原来的十几分之一。也就是说,数据量越大、越接近真实盘口规模,低延时模式带来的收益反而越明显,这对需要覆盖全市场、多品种并行计算的场景尤其关键。
在开发效率上,DolphinDB 的 Orca 流图功能提供了另一种思路。上面提到的整条链路——从原始数据接入、时间序列聚合,到响应式状态计算、结果落库——原本需要手动创建流表、定义共享表结构、逐一配置引擎参数和订阅关系;而借助 Orca,这些步骤可以被压缩成一段声明式的链式调用,像搭积木一样把各个计算环节串联起来。
tradePipeline = g.source(tradeStreamName, 1:0, colNames1, colTypes1)
.dailyTimeSeriesEngine(...)
.reactiveStateEngine(...)
.sink(factorDbname+"/"+tradeMinStreamTbname)
对于需要快速验证新因子、或者频繁调整计算链路的团队来说,这种方式能省下大量重复的"胶水代码"工作,把精力更多放在策略本身上。
结语
把行情接入、因子计算、模型推理和订单撮合放进同一套系统,看起来只是少搭了几个中间层,但对自建量化系统的团队而言,意味着链路调整时不用再重新对齐数据格式、排查状态不同步——研发和验证的周期也就自然缩短了。
更重要的是,这条打通的链路让策略评估能走得更远一步:传统回测系统衡量的往往是信号本身准不准,而这套框架多了一层验证——这个信号,能不能真正变成一笔在盘口上成交的订单,成交结果是否符合预期。策略评估也就从"预测得准不准",往前走到了"这笔交易到底能不能做成"。
归根结底,这反映出量化系统研发正在发生的一个变化:策略验证不再止步于历史数据上的收益曲线,而是要一路问到执行层面——订单能不能成交、成交价格是否合理、盘口流动性会带来多大影响。谁能把这条链路完整地跑通,谁就能更早发现策略在"纸面"和"实盘"之间的落差——而 DolphinDB 正是提供了这样一条路径。
格隆汇声明:文中观点均来自原作者,不代表格隆汇观点及立场。特别提醒,投资决策需建立在独立思考之上,本文内容仅供参考,不作为实际操作建议,交易风险自担。