南方电网 SCADA 项目:无人值守时代,边缘端振动监测需要什么样的数据底座?

在南方电网主变振动监测项目中,开发团队需要在资源有限的边缘设备端完成信号处理及特征计算,并在极低延时下实时计算大量监控指标,同时需要在云端对设备状态进行监控和分析。DolphinDB 能够满足在硬件受限的 ARM 工控机上稳定运行,支持 8~50kHz 高频采样,完成信号处理、特征值实时计算,实现云边协同,同时有效控制了硬件和运维成本。
从“计划检修”到“预测性维护”
在电力行业,定期检修、事后抢修的传统被动运维模式已难以满足新型电力系统对安全性与可靠性的要求。从“计划检修”到“状态检修”再到“预测性维护”,电力设备运维模式变革已成行业共识。其中,振动监测是至关重要的一环,变压器铁芯松动、汽轮机组转子不平衡等早期故障,都可通过振动频谱的细微变化而显现。因此,振动信号被认为是电力设备状态感知中最关键的指标之一。
作为关系国计民生的能源骨干央企,中国南方电网为广东、广西、云南、贵州、海南五省区和港澳地区提供电力服务保障,供电面积 100 万平方公里,服务人口 2.74 亿人。近年来,南方电网将数字化、智能化作为核心战略方向,大力推进人工智能与能源电力深度融合,明确提出以数字技术驱动新型电力系统变革。在南方电网主变 SCADA(振动采集监控系统)项目中,需要在资源受限的边缘设备端,完成信号处理及特征计算;并在极低的延时下,完成大量监控指标的实时计算;同时,需要定时上传数据到云端,以便于在云端对设备状态进行监控和分析。
边缘设备端的三重挑战:部署、吞吐与计算
针对变电站振动监测,传统的技术方案为:边缘端采用 C++/Python 程序+文件存储;数据全量上传中心平台,中心统一分析。在南方电网主变振动监测场景下,传统方案面临以下挑战:
轻量级边缘部署难以实现:南方电网希望将振动监控与故障诊断功能内置到 ARM 工控机中,但现场工控机硬件资源有限,传统计算框架部署包体量大、组件多,无法适配边缘端运行。
高频振动数据实时吞吐压力大:振动传感器采样频率最高可达 50kHz,单台设备每秒产生数万条波形数据,传统方案在边缘端难以稳定承接如此高频的数据流。
复杂信号处理算法难以实时完成:振动故障诊断涉及 FFT 频谱分析、包络解调、小波变换等计算密集型算法,且端到端告警要求毫秒级延迟。传统架构算力调度粗放,无法在资源受限的边缘设备上完成高性能复杂计算。
对此,南方电网选择从数据基础设施层面重构,用云边一体的平台,承接采集、计算、存储全链条。
DolphinDB 如何破局:一套底座,云边协同
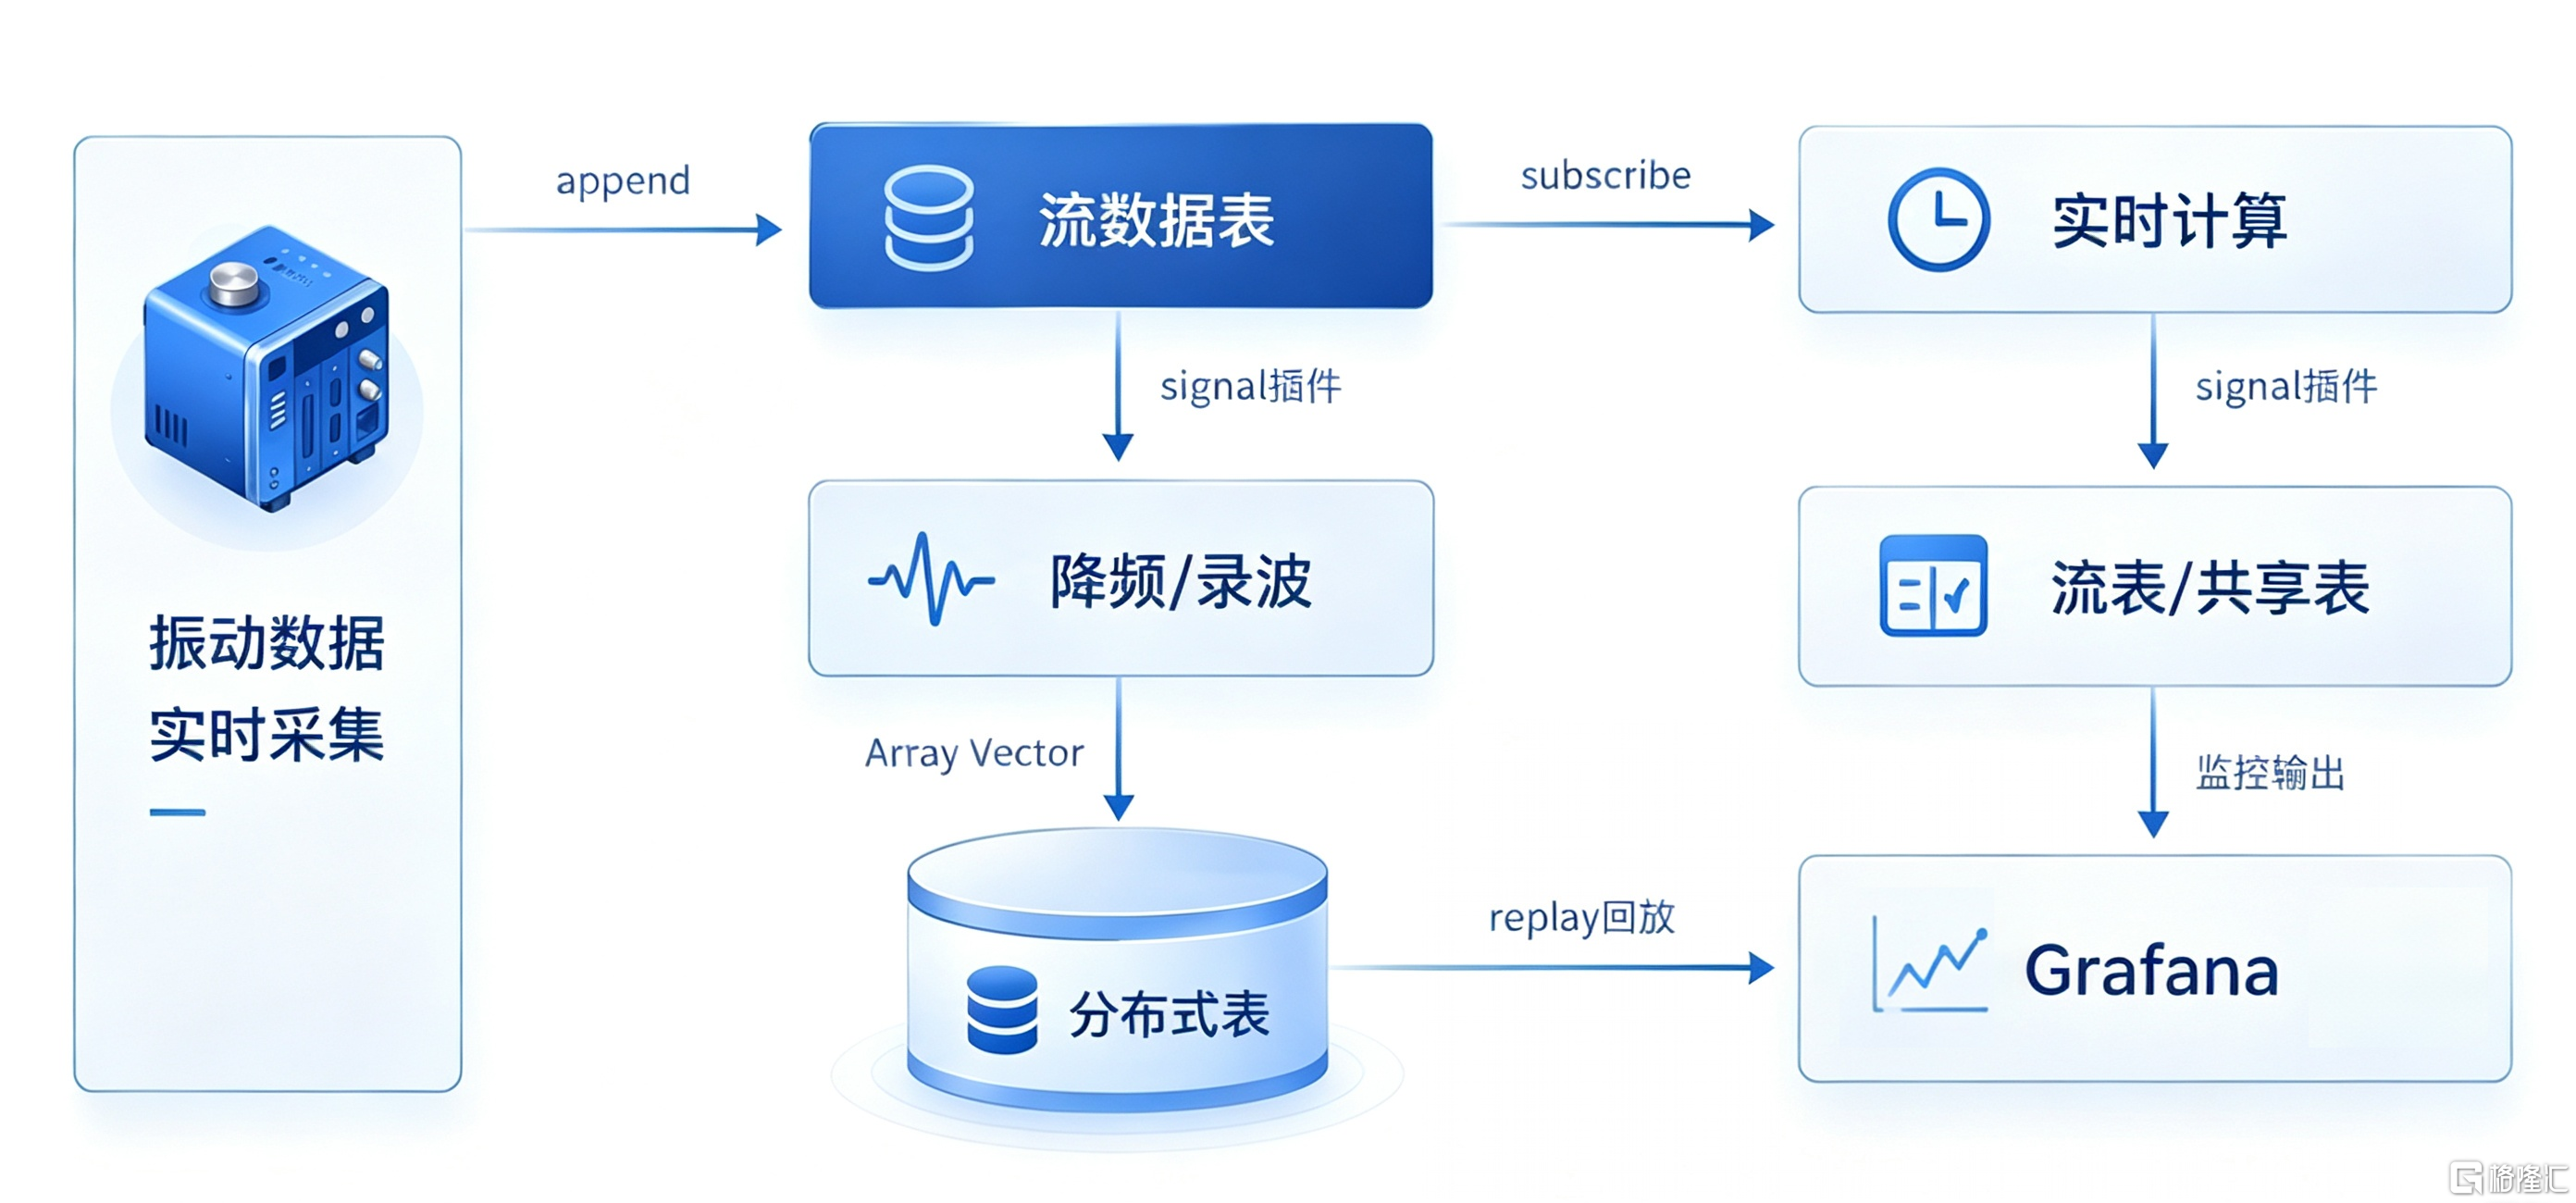
经过严格选型,南方电网最终采用 DolphinDB 构建振动采集监控系统的数据底座。DolphinDB 的解决方案是边缘实时分析引擎 + 云端数据存储底座。
边缘端,在变电站工控机上部署 DolphinDB 单机节点,负责:
TCP 数据接入与解析:通过 TCPSocket 插件对接采集板,内置解析能力完成数据解析
原始帧写入流表:流表用于缓存最近的波形数据,且作为内存计算的载体
异常检测:以向量化手段处理去均值、乘窗函数、FFT、时域特征计算、频域特征计算
异常原波保留与正常波形降采样存储
向中心侧同步告警
中心端(云端),部署 DolphinDB 集群或分析平台,负责:
汇总多个变电站的特征数据
展示告警和事件
回放异常波形与异常分析
进行长期趋势分析
该方案的优势在于:
一体化部署:面对工控机资源受限的现实挑战,部署的程序越多,可用于计算的资源就越少。DolphinDB 将协议解析、时域转换、滤波、异常检测全部收敛到一个进程内完成,振动数据的全生命周期处理都在一个产品里闭环,减少了进程间通信与组件拼装,实现轻量级边缘部署,降低了维护成本。
低资源占用:在硬件资源受限的边缘工控机上,DolphinDB 通过增量计算和向量化处理减少计算开销;并将接入、计算、判定、分发收敛到统一处理链,减少多进程、多中间件带来的线程切换、重复拷贝和内存占用。这种“少组件、短链路、少重复计算”的架构,能有效控制 CPU、内存和存储占用,保障高频数据流的稳定实时处理。
实现高性能复杂计算:DolphinDB 内置的 signal 插件集成了波形计算与傅里叶变换功能,开箱即用,原本动辄上百行的信号处理逻辑,在 DolphinDB 中仅需数行脚本即可完成。计算密集型任务在边缘端就地执行,结合向量化编程,诊断延迟从秒级压缩至毫秒级,实现振动数据的复杂实时计算。
通过 DolphinDB 强大的内置信号处理函数+实时流计算+轻量化边缘部署能力,原本需要靠更强 CPU、更大内存、更高带宽才能支撑的振动采集系统,如今在标准工控机上即可稳定运行全链路功能,提供了控制成本的有效路径。
关键代码实现
以下演示代码构建了从振动数据接入到异常预警的实时处理链路,核心流程为:降采样存储、特征值计算、异常检测与录波。整个过程在数据流入的同时即可完成,无需离线批处理。
使用时序引擎,对原数据进行降采样:
//创建时序引擎,每五分钟保留最后一条原始数据,对原数据进行降采样
metricsDownSampling = parseExpr(each(add,'last(',(`d+string(0..255)+")")))
downsampling = createTimeSeriesEngine(name="downsampling", windowSize=5*60*1000, step=5*60*1000, metrics=metricsDownSampling, dummyTable=wave, outputTable=wave5M, timeColumn=`datetime, keyColumn=`source)
subscribeTable(tableName='wave',actionName="down_sampling", offset=0, handler=append!{downsampling}, msgAsTable=true)
subscribeTable(tableName='wave5M',actionName='save5mToDFS',offset=0,handler=append!{loadTable("dfs://waveDB5M",'waveDB5M')},msgAsTable=true)
上述代码创建了一个时间序列引擎,时间窗口及步长均为 5 分钟,该时间序列引擎会将输入数据按时间进行进行聚合,每五分钟聚合一次并返回最后一条记录存储到 wave5M 表中。并创建了两个订阅:
down_sampling 订阅 wave 流表并注入时间序列引擎中进行降采样
save5mToDFS 订阅 wave5M 流表,将降采样后数据存入分布式库表中
使用时序引擎,计算每秒波形峰值:
//定义处理函数
def metricCal(engineName,msg){
t = select datetime,source,rowMin(msg[,2:258]) as min,rowMax(msg[,2:258]) as max from msg
getStreamEngine(engineName).append!(t)
}
//定义聚合规则
metrics=<[max(max),min(min)]>
inputSchema = table(100:0, `datetime`source`min`max,[TIMESTAMP,SYMBOL,DOUBLE,DOUBLE])
//创建时序引擎,窗口为1s,步长为1s
tsAggr1 = createTimeSeriesEngine(name="tsAggr1", windowSize=1000, step=1000, metrics=metrics, dummyTable=inputSchema, outputTable=stwave, timeColumn=`datetime, keyColumn=`source)
//订阅wave表,进行指标计算
subscribeTable(tableName="wave", actionName="act_tsAggr1", offset=0, handler=metricCal{"tsAggr1"}, msgAsTable=true);
//订阅stwave表,将峰值趋势入库
subscribeTable(tableName='stwave',actionName='savePeakToDFS',offset=0,handler=append!{loadTable("dfs://waveDB",'waveDB')},msgAsTable=true)
上述代码首先订阅 wave 流表,计算每一行测点的最大值和最小值,并将计算结果输入时间序列引擎 tsAggr1 中,聚合输出每秒波形数据的峰值,存储到 stwave 流表中。之后订阅 stwave 表,将峰值趋势数据入库。
创建异常检测引擎,进行异常检测:
//创建异常检测引擎,检测规则 max>100000,min<-100000
tsAggr2 = createAnomalyDetectionEngine(name="tsAggr2", metrics=<[max_wave > 100000, min_wave <-100000]>, dummyTable=stwave, outputTable=warn, timeColumn=`datetime, keyColumn=`source, windowSize=60*1000, step=60*1000)
//订阅stwave 进行异常检测
subscribeTable(tableName="stwave", actionName="act_tsAggr2", offset=0, handler=append!{tsAggr2}, msgAsTable=true);
//订阅warn表,将异常记录入库
subscribeTable(tableName='warn',actionName='saveWarnToDFS',offset=0,handler=append!{loadTable("dfs://warnDB",'warnDB')},msgAsTable=true)
创建异常检测引擎,并订阅峰值流表 stwave,将异常结果(max_wave > 100000, min_wave <-100000)输入异常记录表 warn 中,并将异常数据订阅入库。
DolphinDB 引领电力行业降本增效新路径
在南方电网主变振动监测项目中,DolphinDB 有效解决了振动数据特征值计算与存储、云边协同等难题,在普通工控机上实现毫秒级实时监控和低延迟故障预警;同时,在系统架构层面,一个 DolphinDB 就替代了“实时数据库+流处理引擎+信号分析工具”的组合,大幅降低了部署和运维的成本。
面对振动监测这一电力行业中“存不动、算不起、管不过来”的硬骨头,DolphinDB 在南方电网的实践中证明了一条可行的路径:不靠堆硬件换性能,而靠软件架构集约化释放硬件潜能。当高频采集、实时计算、云边协同在工控机上落地,对于正加速迈向状态检修和预测性维护的电力行业而言,这或许就是大规模智能运维的未来。
格隆汇声明:文中观点均来自原作者,不代表格隆汇观点及立场。特别提醒,投资决策需建立在独立思考之上,本文内容仅供参考,不作为实际操作建议,交易风险自担。