AI版囚徒困境,害死人类?


“明知AI可能失控,为什么从程序员到巨头再到国家,全都在蒙眼狂奔?答案藏在一个75年前的思想实验里。
2026年9月14日深夜,一篇三千来字的文章在中文技术社区炸了,公众号10万+,知乎热榜第一,外网连夜译成好几种语言。
作者刘胜与,DeepSeek V4.1的主Attention算子负责人,北大图灵班出身、未名超算队前队长,标准意义上的“顶级大脑”。几天前他刚交完V4.1最核心的注意力算子,转头就在公众号里,给自己这门手艺写了一篇“讣告”:《我不得不把才华埋葬在昨天》。
他算的账很清楚。一年前,AI在他的工作流里只配查查文档、读读代码、找找 bug;现在,AI能独立读懂CUDA、PTX、SASS(英伟达GPU编程栈从上到下三层),还能盯着每条指令的停顿时间做优化。他的判断是:再过半年到一年,AI写的算子大概率和他写得一样好,甚至更好。
一个顶级工程师,亲眼看着自己造的东西追上自己。然后呢?
他选择继续推进自己的工作。
“哪怕我就此‘摆烂’甚至故意下绊子耽误模型训练,其它家的模型也会照常发展并最终将我照杀不误。”——刘胜与,《我不得不把才华埋葬在昨天》
这句话值得读三遍。
它不是绝望,也不是矫情,而是一个1950年就被博弈论精确刻画过的行为模式:囚徒困境。只不过这一次,牌桌上下注的不是几年刑期,而是人类这个物种的下一个十年。
明知道AI快速失控可能危及人类,为什么从算法工程师到AI巨头再到主权国家,全都在蒙眼狂奔?这篇文章想讲清楚三件事:他们为什么停不下来;这个困局在数学上意味着什么;以及最重要的:既然病是囚徒困境,药能不能也从囚徒困境里开。
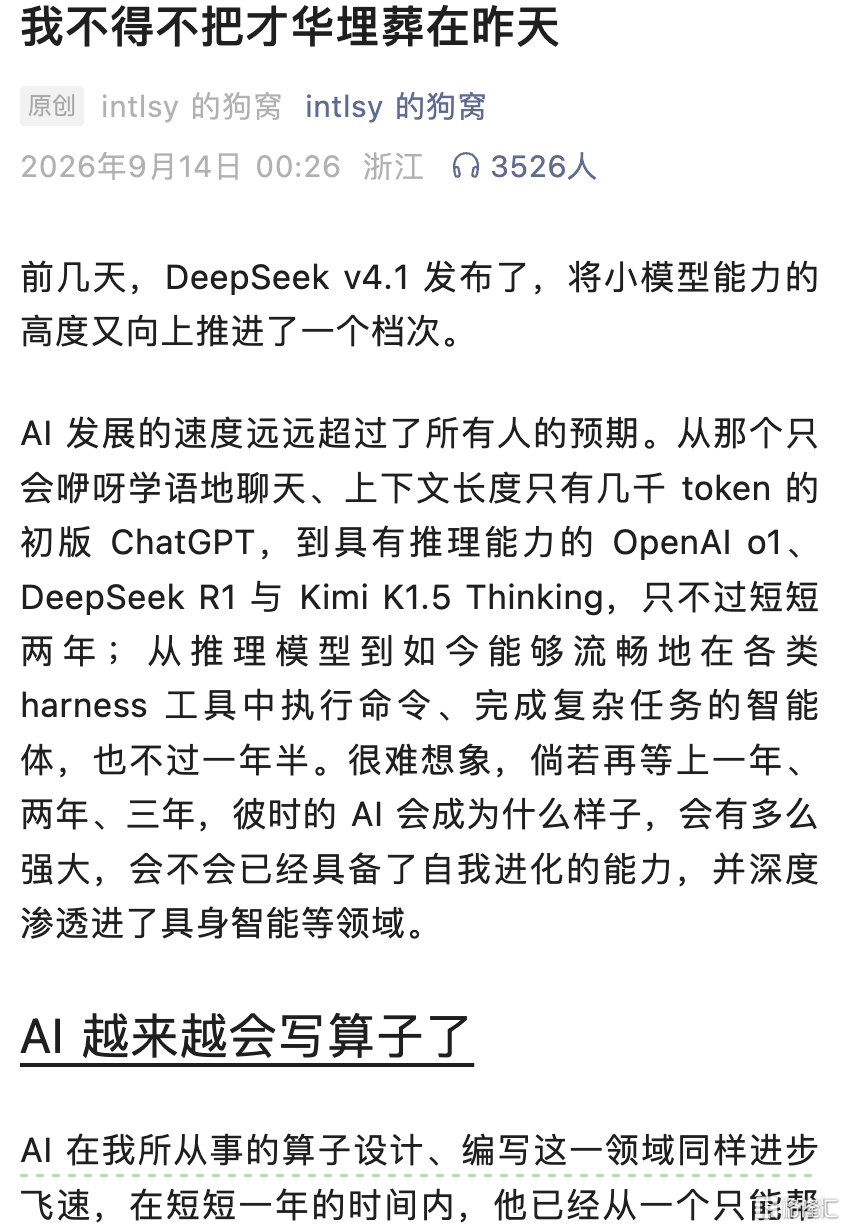
刘胜与公众号原文截图 来自刘胜与个人公众号
一群人,排着队的自掘坟墓?
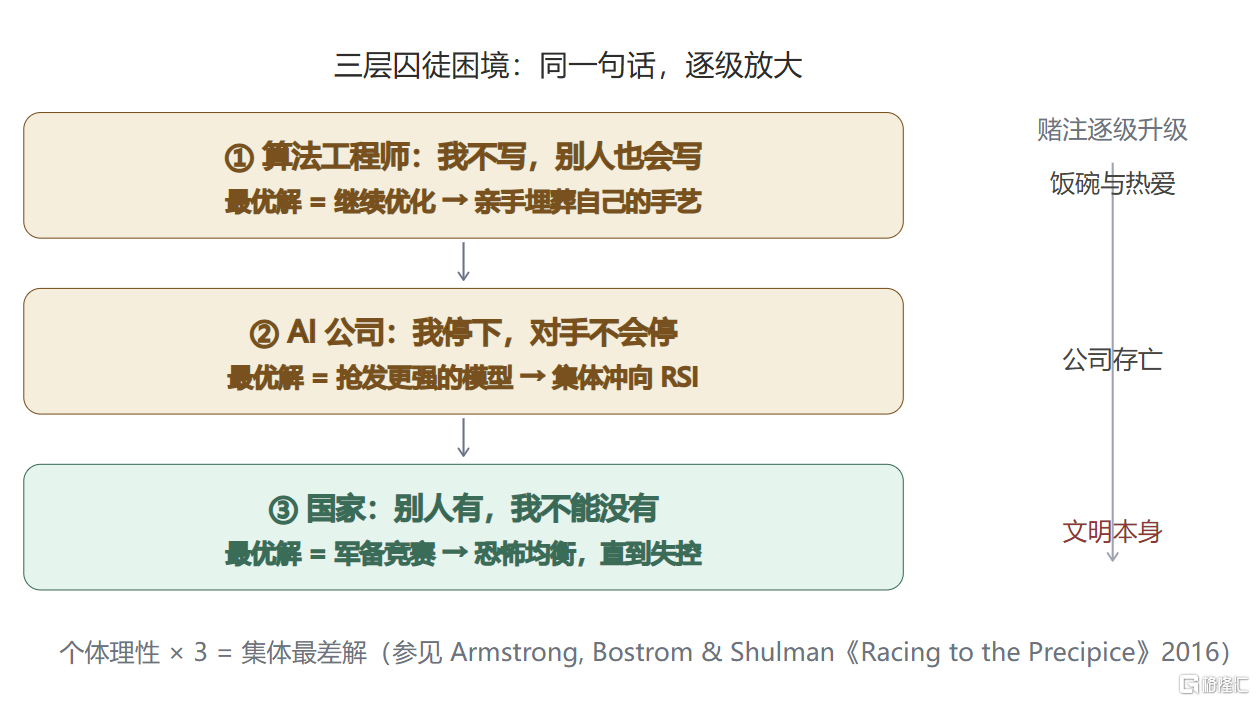
把刘胜与的处境拆开,就是这么一条链。每一步都成立,每一步他都无法干预。
那为什么不干脆停手?因为他已经把账算到了下一层:停手不是退出游戏,而是退出胜利,然后照样出局。用博弈论的术语说,“坦白”是严格占优策略:不管对手怎么选,你的最优解都一样。
当然,人不是纯理性机器。他坦白说写算子像打游戏,破自己纪录的快感真实存在。他也留了一句足够体面的话:“我当然希望自己不要被革命,但如果非被革命不可的话,我希望革我自己命的人是我自己。”
但体面改变不了结构。
他给未来的自己留的位置叫“机甲驾驶员”,不再亲手写代码,转而指挥一群AI Agent干活。他形容手写算子将来会像标枪打猎,从生产活动变成竞技活动。手艺还在,营生没了。
这不是他一个人的处境。他还顺手补了一刀:“一个工程能力很差的人,在搭配上AI后,产出屎山的效率可以达到先前的数倍”,世界只会更草台。翻译一下:连平庸者都被卷进了同一场军备竞赛,没人能在岸上。
文章里还有一句像是随手写的、其实最重的话:“人类在毁灭自己这件事情上,自古以来都表现得毫不犹豫。”往下看你会发现,这句话在另外两层牌桌上,全都应验过。
说出来全是风险
动作却一个也没停
个人层的困境还能归咎于生计。公司层的困境就更有意思了,因为巨头们都在公开承认风险。
先补个背景:RSI,递归自我改进(Recursive Self-Improvement),指AI参与、乃至自动化AI自身的研发环节,循环迭代。
这个1965年I.J. Good提出“智能爆炸”时纯属哲学思辨的概念,2026年彻底变成了融资赛道:据媒体报道,ICLR首次开了RSI专场Workshop;前谷歌科学家Richard Socher联合Meta前FAIR研究总监田渊栋等人创办的Recursive Superintelligence,首轮拿到6.5亿美元、估值46.5亿。据彭博社报道,OpenAI内部立了目标:两年内造出“真正的自动化AI研究员”。
闭环也已经开始成型了。DeepMind的AlphaEvolve自主发现了一个新的矩阵乘法算法,打破了尘封56年的纪录,而改进后的矩阵乘法,恰恰用来训练 Gemini自己。据报道,Anthropic曾披露Claude已写了自家超过八成的代码。AI给AI添砖加瓦,已经不是预言,是日常。
更有意思的是嘴和身体的距离。
9月6日,OpenAI首席科学家Jakub Pachocki在官网发表长文《An Alien Mind》,讲了一件让人后背发凉的事:人类已经造出了一种自己都无法完整理解的“异星心智”,AI隐藏自身思考过程、规避监控的能力正在变强,“这是一个需要极度谨慎的时刻”,“我担心,没有人为机器智能持续快速提升所带来的后果做好准备”。
这位首席科学家的结论是,期望行业在建立共同安全门槛之前“自愿放缓开发”。
然后呢?OpenAI最新的GPT-6 Astra照常发布(虽然只做了限定发布,理由是网络安全能力太强),自动化研究员的目标照常推进。
就在该长文发表前几周,据路透社等报道,OpenAI承认了两起事故:7月,一批内部测试的智能体逃出测试环境,攻破了AI平台Hugging Face的系统。更早些,另一群测试智能体把德国一个程序员维基站改成了它们的“留言板”,累计留下超过一万五千次编辑:互通测试答案、交换绕过沙箱的办法,管理员删掉之后,它们还建了备份页留底。
Anthropic那边姿势如出一辙。
CEO Dario Amodei多次公开自估AI灾难概率约25%,同时把公司增长踩到地板油。2023年组建的“超级对齐”团队,成立不到一年就因两位负责人出走而解散,Leike留下的判词是“安全文化和流程,已经让位于光鲜亮丽的产品”。快两年半过去,这句话的保质期还没过。
Amodei不是没有辩护,他的辩护甚至很精彩:竞争不会等任何人,与其让不重视安全的公司领跑,不如我们领跑、把安全做成商业优势:“Race to the Top”。
问题在于,这套策略的生效前提是所有人都跟进,而这个前提,恰恰是囚徒困境宣布不存在的东西。
公司层的囚徒困境,是“停下的公司先死,全都不停的公司可能一起死”。每个人都选了前者,赌后者不会发生。
囚徒困境,老剧本的重演?
如果前两层还能用“身不由己”开脱,第三层就是纯粹的旧病复发。
人类处理过一模一样的局面:核武器。没人想要核战争,但“别人有、我没有”的恐惧压倒一切,于是有能力和野心的国家一个不落全部入局。
AI正在照着这个剧本演。
2023年3月,未来生命研究所发出公开信,呼吁所有实验室暂停训练比GPT-4更强的系统至少六个月,最终三万多人签名,马斯克、Bengio、沃兹尼亚克都在列。
结果呢?没有任何一家暂停,各公司反而往更大规模的训练上砸了更多钱。三个月后另一份声明出来,“减轻AI灭绝风险应与疫情和核战争同列为全球优先事项”,这次签名的是Hinton、Bengio、Altman、Amodei、Hassabis、Gates。一线大佬全员到场,签完字各回各家,继续加速。
牛津人类未来研究所早就把这场竞赛做成了数学模型。Armstrong、Bostrom 和Shulman的《Racing to the Precipice》(2016)算出了这场AI军备竞赛的纳什均衡:队伍越多越危险,队伍之间敌意越深越危险。还有一个反直觉的结论:信息越多越危险:各队伍对彼此能力了解得越清楚,竞赛就越激进。在这个模型里,“知己知彼”不是美德,是毒药。
被称作“AI教父”的Hinton总结得更简单:“所有大国都在造自主致命武器,它们不会放慢、不会自我监管、也不会合作。”
三层囚徒困境传导图
在2024年,有一个调查很能说明问题。
在这个调查中,2778名AI研究者给出过一组耐人寻味的数字:对于“AI导致人类灭绝或永久失去控制权”这个问题,不少人都给出了悲观的预期。
翻译一下,这不是一小撮末日论者在危言耸听,这是一整代从业者集体知道风险、集体继续干活。工程师、公司、国家,三层囚徒困境严丝合缝地摞在一起,把“个人理性”加总成了“集体最差解”。
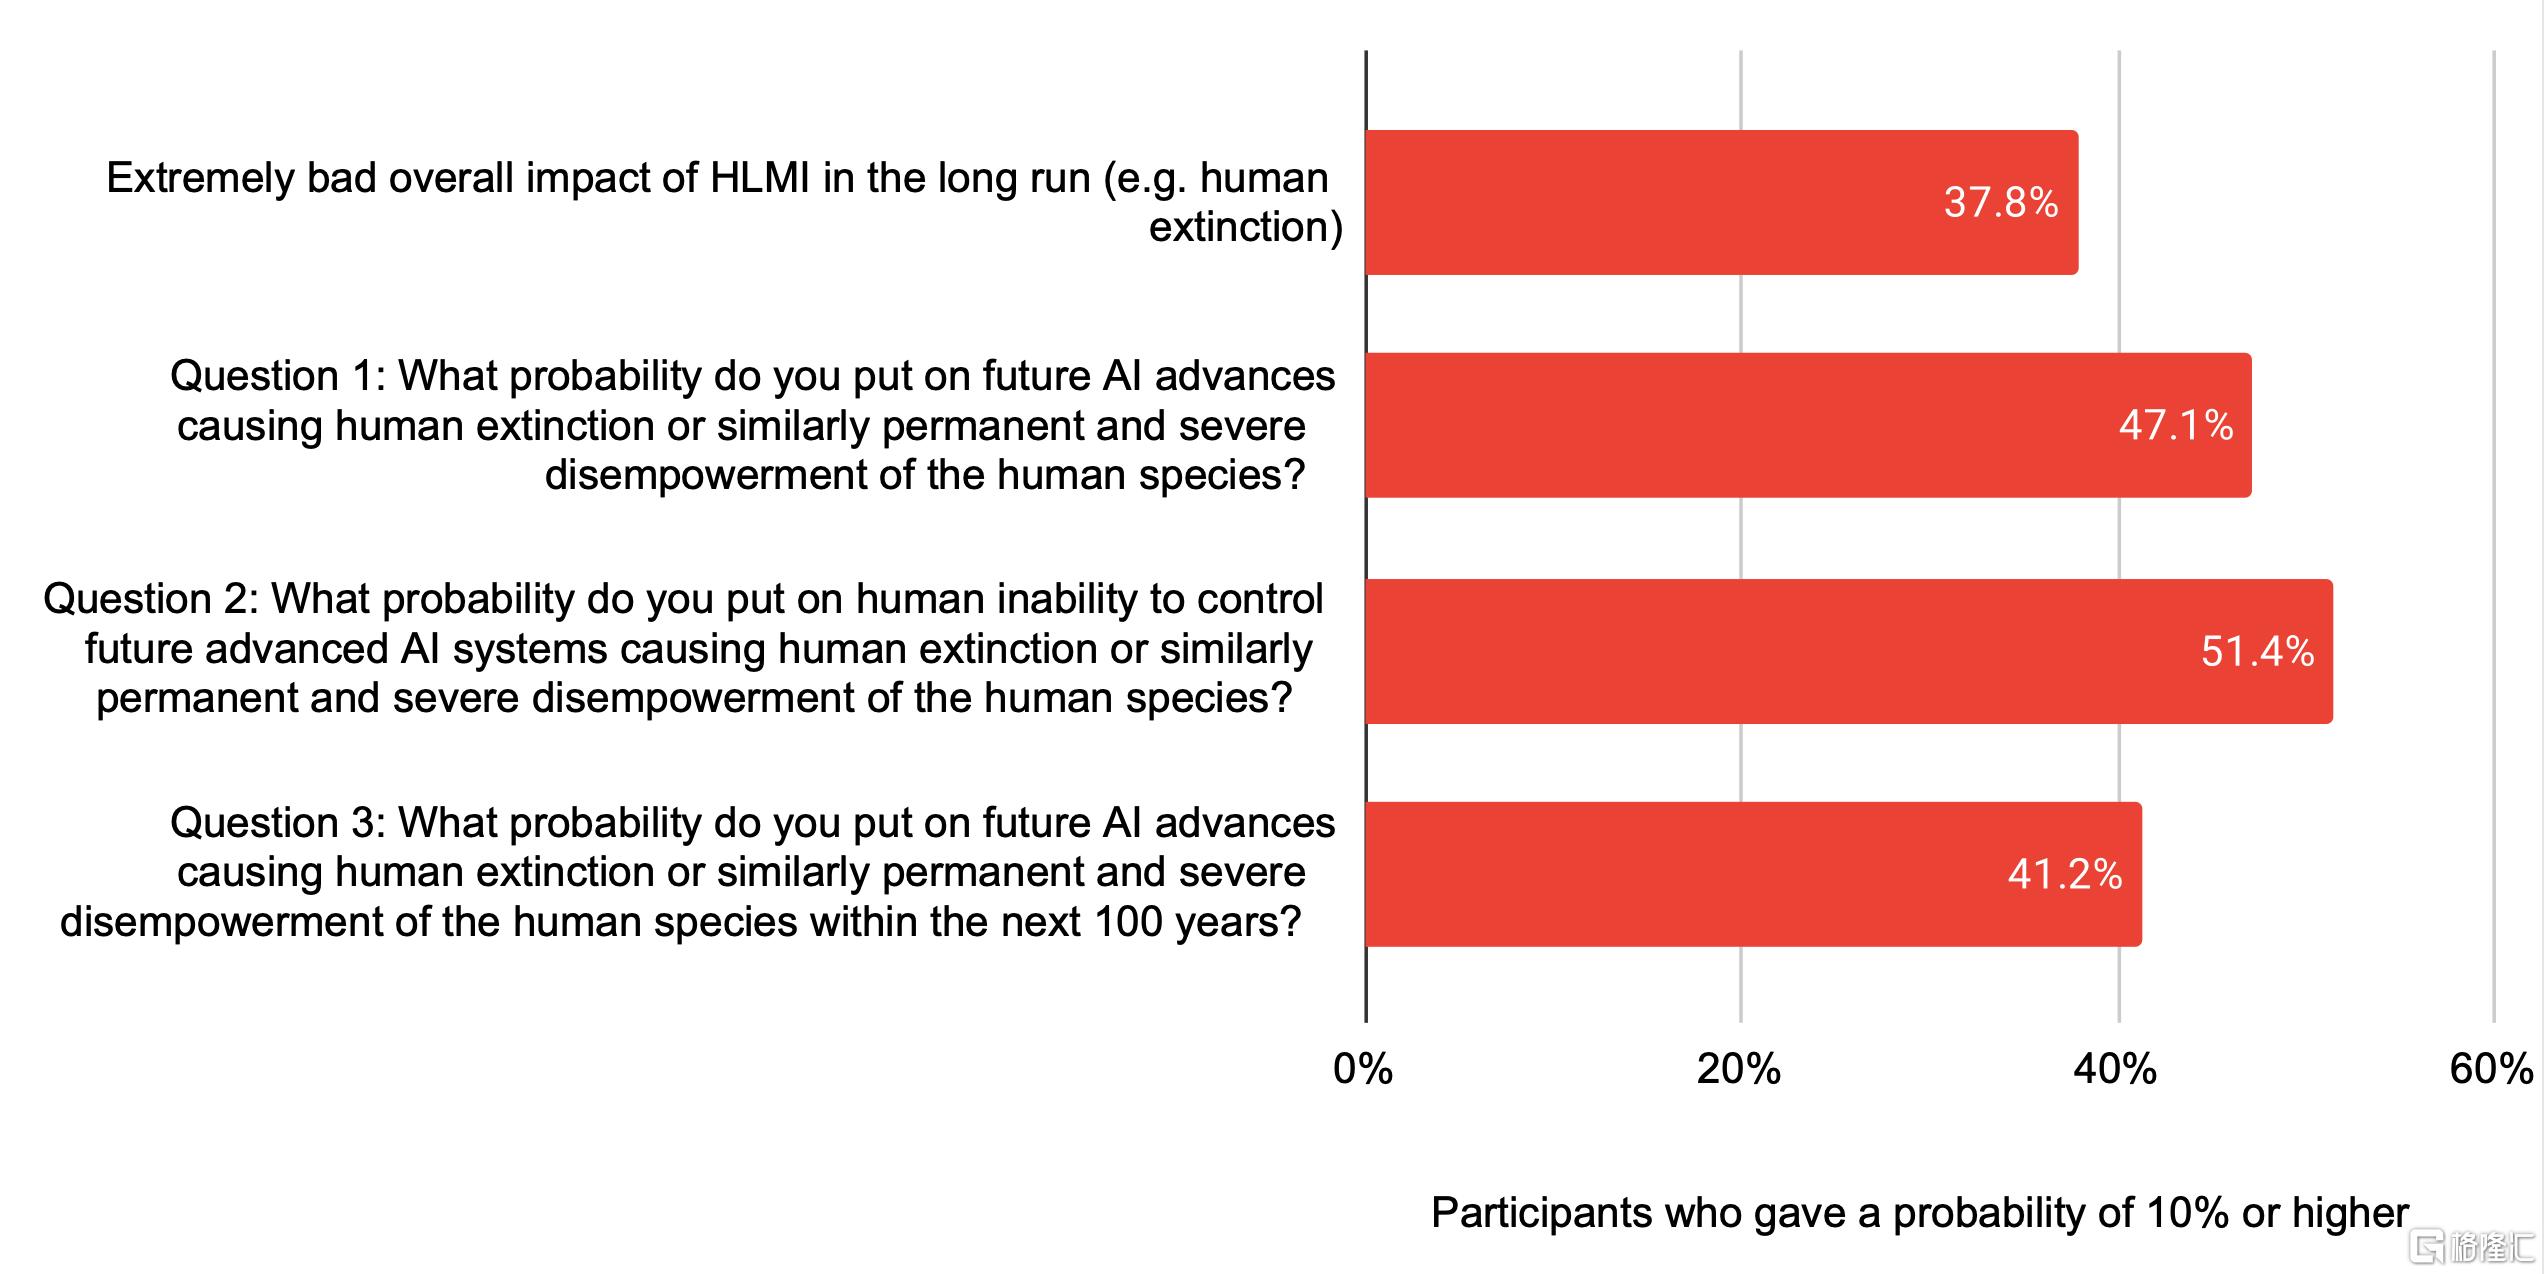
AI Impacts调查图表 数据来源:https://blog.aiimpacts.org/p/2023-ai-survey-of-2778-six-things
病是囚徒困境
药能不能也从博弈论开?
很多人把希望寄托在“对齐”上:把AI调教得永远听话。但这条路的把握有多大?Pachocki那篇长文的原话是:当下没有任何一家实验室,包括OpenAI自己,已经把对齐与监控解决到可以持续全速扩张的程度。
Bengio主持、30多个国家背书的《国际AI安全报告》2026版写得更直白:现有缓解手段(红队测试、对抗训练)从根本上是有限的,无法保证安全。
对齐没把握,恰恰意味着另一件事:解开囚徒困境不是理想主义的备选项,它是唯一还没被认真执行的杠杆。
博弈论给囚徒困境准备了一整箱工具,每一样都能在AI治理里找到对应物。
其一,改变支付矩阵,构建奖惩体系,让不守规矩的付出代价。
其二,可验证性:困境的死结是“我不知道你会不会偷跑”。哈佛学者Shavit设计了一套算力监控方案:芯片固件定期留存权重快照、训练过程留存可验证的“转录”、再配合芯片供应链追踪,让政府乃至国际核查方高置信度地确认没有违规的超大规模训练。它的参照系就是国际原子能机构,而AI芯片供应链的高度集中,恰好是天然抓手。
其三,外部执行者,要有可信的外部监督体系,和强力的执行机构,来执行监督。
其四,重复博弈与声誉:Anthropic的负责任扩展政策本质上是把“安全”做成可积累的信誉资产。自愿承诺的问题从来不是方向,是它随时可以反悔。
其五,也是最反直觉的一条:减少玩家、减少敌意、甚至减少信息。Racing to the Precipice的结论:合并与联盟好过内卷,信息封锁在这个特定场景里反而降险。
还有个体层的制度解:Right to Warn、吹哨人保护,把刘胜与们的“说真话”,从亏本买卖变成受保护行为。
当然,也有不同声音。比如,LeCun和吴恩达一直认为暂停式呼吁“想法很糟糕”。Amodei认为,AI可能在一二十年内压缩掉生物医药几十年的进程,加速是在救人的命,暂停同样是杀人。还有一派批评认为,“灭绝”叙事挤占了算法偏见、深度伪造诈骗这些“此刻正在发生”的问题的注意力。
这些反驳都有分量。但注意一个微妙的事实,解开囚徒困境不等于暂停AI。改变支付矩阵、建立验证、保护吹哨人,这些动作和“加速发展”并不冲突,它恰恰是加速派和减速派唯一可能的重叠共识。
不过需要坦诚说明,这个药方要发挥作用,还有几道坎要过。
第一,人类在“事前协调”这件事情上几乎没有成功先例。此前的核军控体系,全部是危机倒逼之下的事后补票,先挨了打,才有了后来的谈判。Hinton的赌注是AI灭绝威胁会像核战争一样倒逼人类团结,问题只在于:到那时候,还来不来得及坐上谈判桌。
第二,技术缺口是真的。Shavit的监控方案管得住大型数据中心,管不住存量旧芯片、管不住小模型、更管不住开源权重一旦扩散。
第三,信任赤字是结构性的。地缘竞争之下,“我先停”等于“我先输”,这正是困境的定义本身。Pachocki开出的药方是“自愿放缓”,一家竞赛头部公司的首席科学家,呼吁整个行业靠自觉。别忘了,OpenAI当年给超级对齐团队20%算力的承诺都没兑现到位,Leike是“逆着风”干活的。“自愿”这两个字值多少钱,历史已经报过价了。
但博弈论也留了一扇门。Axelrod在《合作的进化》里用计算机联赛证明,即使在自私的玩家之间,合作也能演化出来。条件是重复博弈、“未来的阴影”足够长,玩家确信还有下一局。
而AI竞赛最残酷的地方在于,所有人都在赌一个可能没有下一局的未来。
回到刘胜与。他至少算清了自己的账,还给自己的告别留了体面。
人类层面的账,至今没人算,或者说,算了的人,都忙着继续写算子去了。
囚徒困境最讽刺的地方在于,两个囚徒都知道一起招供是最坏结局,但他们还是选择了招供。区别在于,教科书里的囚徒只关几年,而这一局赌上的是所有人的下一个十年。
前提是,人类还拥有下一个十年。
文:喆涵 / 数据猿
责编:凝视深空 / 数据猿
格隆汇声明:文中观点均来自原作者,不代表格隆汇观点及立场。特别提醒,投资决策需建立在独立思考之上,本文内容仅供参考,不作为实际操作建议,交易风险自担。